Dix ans après AlphaGo : comment l’intelligence artificielle a transformé le Go
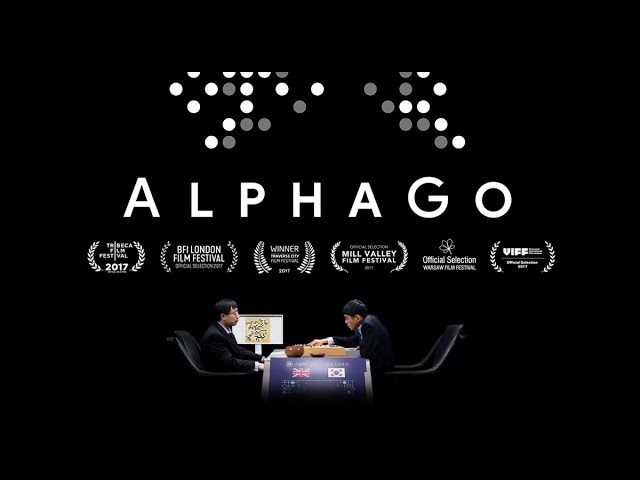
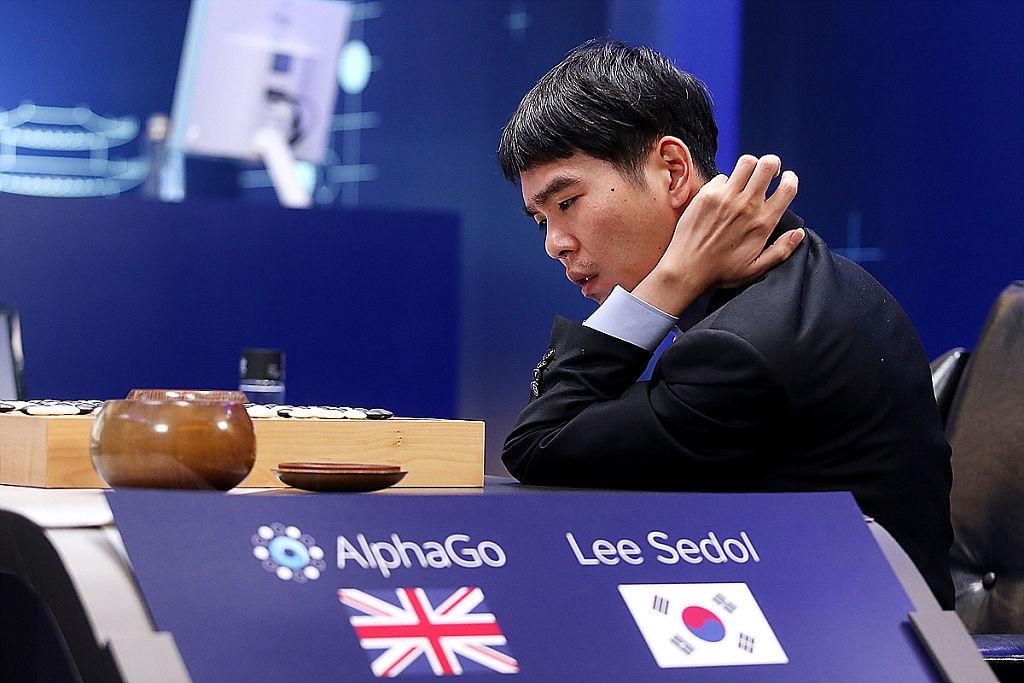
En mars 2016, dans un hôtel de Séoul, un événement allait bouleverser les certitudes du monde du Go. Pendant cinq parties, Lee Sedol, l’un des plus grands joueurs de sa génération, affrontait AlphaGo, un programme développé par la société britannique DeepMind, rachetée deux ans auparavant par Google. Le champion coréen avait derrière lui une carrière exceptionnelle, dix-huit titres mondiaux et une réputation de combattant particulièrement inventif. Son adversaire n’avait ni expérience humaine du jeu, ni maître, ni intuition au sens où les joueurs emploient habituellement ce mot.
À l’issue de la rencontre, AlphaGo l’emportait par quatre victoires à une.
Le résultat était considérable pour les chercheurs en intelligence artificielle, qui venaient de franchir une étape longtemps jugée hors de portée. Pour les joueurs de Go, il soulevait des questions peut-être plus troublantes encore. Comment une machine avait-elle pu atteindre un tel niveau dans un jeu dont la richesse semblait précisément résister aux méthodes informatiques traditionnelles ? Et que fallait-il penser de certains coups qui paraissaient contraires aux enseignements reçus depuis des générations ?
Dix ans plus tard, le souvenir de cette rencontre reste associé à quelques images célèbres et à deux coups entrés dans l’histoire. Pourtant, ses conséquences dépassent largement les cinq parties disputées à Séoul. Les ouvertures ont évolué, des joseki ont été réexaminés, les professionnels ont découvert de nouvelles manières d’étudier et les amateurs disposent aujourd’hui d’outils d’analyse dont la puissance aurait été inimaginable quelques années auparavant.
Cette révolution a ouvert des perspectives considérables. Elle a également posé une question qui mérite toujours d’être discutée : que gagne-t-on à apprendre d’une intelligence artificielle qui joue mieux que nous, mais dont les choix ne sont pas toujours faciles à comprendre ?
Pourquoi le Go représentait un défi si particulier
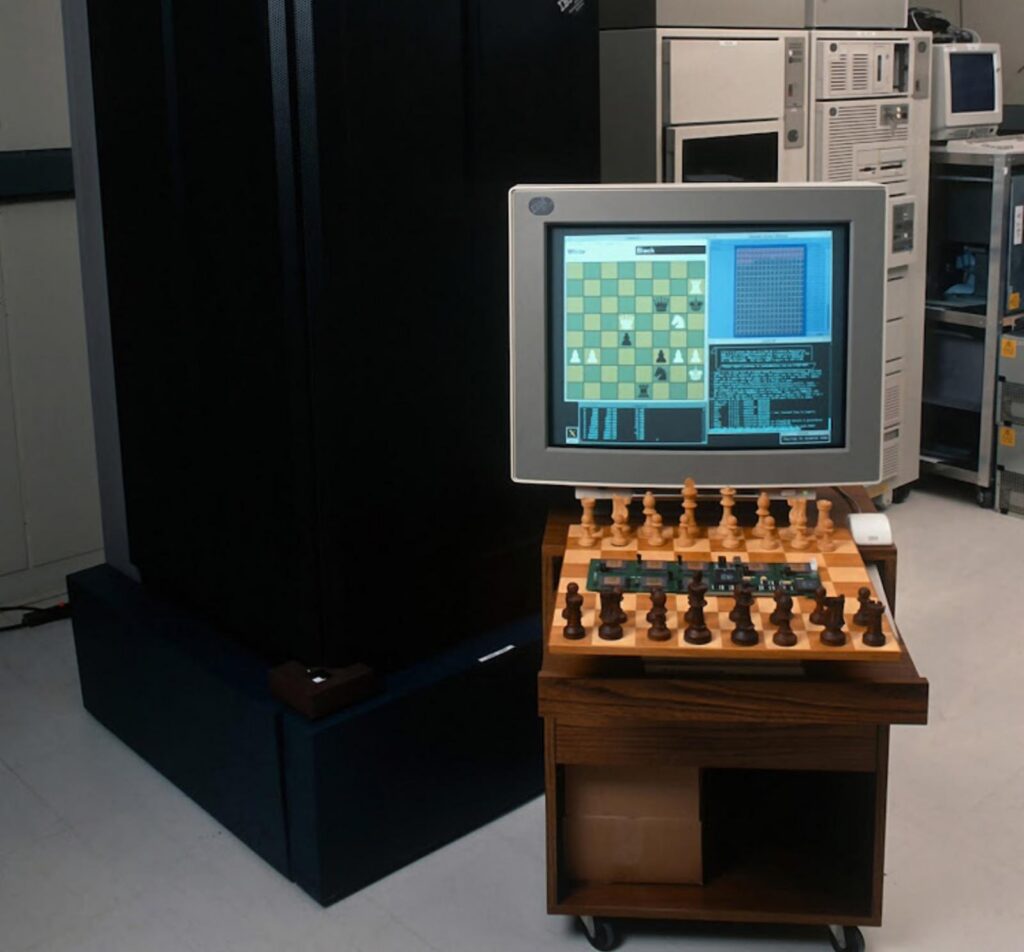
Bien avant AlphaGo, l’informatique avait déjà remporté une victoire spectaculaire contre les meilleurs joueurs d’échecs. En 1997, Deep Blue, développé par IBM, battait Garry Kasparov dans une rencontre en six parties. On pouvait donc imaginer qu’un programme finirait également par dépasser les champions de Go, même si personne ne savait précisément quand.
Le problème était cependant d’une autre ampleur. Sur un échiquier, le nombre de coups légaux disponibles à chaque tour reste relativement limité. Au Go, un plateau de 19×19 offre 361 intersections au départ et, même après plusieurs dizaines de coups, les possibilités demeurent extrêmement nombreuses. Les variantes se multiplient à une vitesse telle qu’il devient impossible de les explorer exhaustivement, même avec une puissance de calcul considérable.
À cette difficulté s’en ajoute une autre : il n’est pas simple d’évaluer la qualité d’une position. Aux échecs, la valeur du matériel conservé peut fournir un premier repère, même si elle ne suffit évidemment pas à juger une partie. Au Go, une pierre ne possède aucune valeur fixe. Elle peut contribuer à la solidité d’un groupe, exercer une influence sur une région éloignée, devenir un sacrifice utile ou perdre toute importance selon l’évolution de la position.
Les meilleurs joueurs apprennent progressivement à reconnaître ces relations. Ils développent une compréhension des formes, de l’équilibre entre territoire et influence, des groupes forts et faibles, et de la direction générale du jeu. Cette connaissance ne se laisse pas toujours traduire en règles explicites. On peut expliquer pourquoi un coup est bon dans une situation particulière sans pouvoir formuler une recette qui fonctionnerait dans toutes les positions comparables.
Pendant longtemps, les programmes informatiques de Go sont donc restés très inférieurs aux professionnels. Les progrès des recherches arborescentes fondées sur des simulations leur avaient permis d’atteindre des niveaux amateurs de plus en plus élevés, mais le sommet du jeu semblait encore relativement éloigné.
C’est dans ce contexte que l’arrivée d’AlphaGo a constitué une rupture.
Fan Hui, puis Lee Sedol : deux étapes décisives
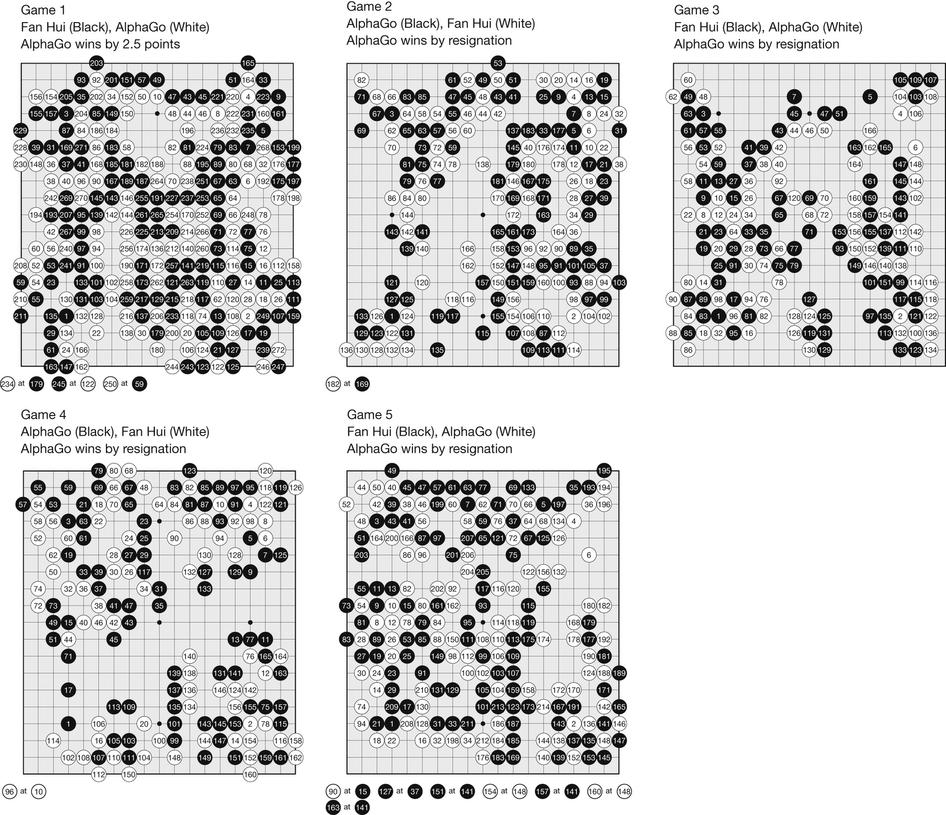
L’histoire publique d’AlphaGo commence véritablement en janvier 2016, lorsque les chercheurs de DeepMind annoncent dans la revue scientifique Nature les résultats d’un programme combinant plusieurs méthodes d’apprentissage automatique et de recherche. Quelques mois auparavant, en octobre 2015, AlphaGo avait affronté Fan Hui, professionnel chinois installé en France et alors triple champion d’Europe.
Le résultat, cinq victoires à zéro pour le programme, constituait une première historique : une machine venait de battre un joueur professionnel sans handicap sur un goban de 19×19, dans les conditions d’une véritable rencontre. Fan Hui occupait une place particulière dans le monde européen du Go, où il contribuait également à l’enseignement et au développement de la pratique. Sa participation allait ensuite se prolonger auprès de l’équipe de DeepMind.
Il restait toutefois une interrogation essentielle. Battre un professionnel européen ne signifiait pas nécessairement pouvoir rivaliser avec les meilleurs joueurs de la planète. Entre les professionnels de différents niveaux, les écarts peuvent être considérables, et les champions asiatiques possèdent une expérience des compétitions de très haut niveau difficile à comparer à celle des joueurs évoluant principalement sur le circuit européen.
C’est pourquoi le choix de Lee Sedol donnait à la confrontation suivante une tout autre dimension. À trente-trois ans, le Coréen était l’une des figures majeures du Go mondial, réputé pour ses combats complexes, sa créativité et sa capacité à trouver des ressources dans les positions les plus difficiles.
Les cinq parties furent disputées les 9, 10, 12, 13 et 15 mars 2016, à Séoul. AlphaGo remporta les trois premières, assurant sa victoire dans la rencontre dès le 12 mars. Lee Sedol gagna la quatrième, avant de s’incliner dans la dernière.
L’événement suscita une attention médiatique exceptionnelle. Les parties étaient retransmises en direct, commentées par des professionnels, discutées sur les serveurs de Go et suivies bien au-delà du cercle habituel des amateurs. Pour beaucoup, il ne s’agissait plus seulement de savoir qui jouerait le mieux, mais de découvrir jusqu’où une machine pouvait aller dans un domaine longtemps associé à l’intuition et au jugement humains.
Le trente-septième coup : quand AlphaGo surprend les professionnels
La deuxième partie, disputée le 10 mars, est restée célèbre pour un coup qui a profondément marqué les observateurs.
AlphaGo jouait Noir. Au trente-septième coup, alors que les deux adversaires avaient déjà commencé à développer leurs positions, le programme plaça une pierre sur le côté droit du goban, dans une zone où les commentateurs ne s’attendaient pas à voir jouer.
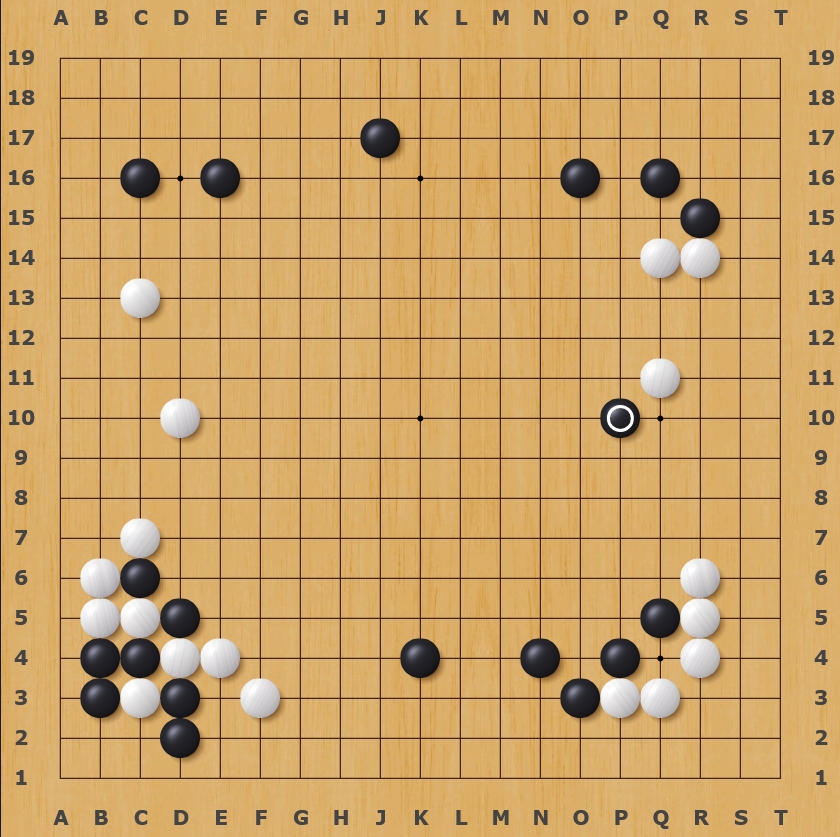
Il s’agissait d’un coup à l’épaule, relativement haut, dont l’objectif et les conséquences n’étaient pas immédiatement évidents. Le problème n’était pas qu’un tel geste fût inconnu des joueurs de Go : les coups à l’épaule appartiennent depuis longtemps au vocabulaire tactique et stratégique du jeu. Ce qui surprenait, c’était son emplacement et sa pertinence apparente dans la position globale.
Les réactions des professionnels présents montrent combien ce choix déroutait. Certains se demandaient si le programme avait commis une erreur. D’autres reconnaissaient qu’ils ne parvenaient pas à en apprécier immédiatement la valeur. Le coup semblait s’écarter des habitudes admises, sans pour autant pouvoir être réfuté par une lecture évidente.
AlphaGo poursuivit sa partie et finit par l’emporter.
Il serait excessif de tirer de cette seule victoire la preuve que le coup 37 était la meilleure décision possible. Sa célébrité tient surtout à ce qu’il révélait : une machine pouvait désormais proposer, au plus haut niveau, des choix qui échappaient aux attentes des experts humains et méritaient d’être examinés sérieusement plutôt que rejetés parce qu’ils paraissaient inhabituels.
Le Go avait déjà connu de semblables remises en question. Dans les années 1930, Go Seigen et Kitani Minoru avaient contribué à renouveler la réflexion sur les ouvertures, notamment en donnant une importance nouvelle à certains coups éloignés des modèles traditionnels. La comparaison avec AlphaGo n’est pas parfaite, mais elle rappelle qu’une conception stratégique largement admise n’a jamais constitué une vérité définitive.
La différence, cette fois, tenait à l’origine de l’innovation et à la vitesse avec laquelle elle allait se diffuser.
La deuxième partie AlphaGo-Lee Sedol
La quatrième partie : Lee Sedol trouve une réponse
Si la deuxième partie demeure associée à l’inventivité d’AlphaGo, la quatrième a acquis une place tout aussi importante dans la mémoire du Go contemporain.
Le 13 mars, Lee Sedol se trouvait dans une situation particulièrement difficile. Il avait perdu les trois premières manches et la rencontre était déjà mathématiquement décidée. Pour autant, le champion n’avait aucune intention de renoncer à chercher une victoire.
AlphaGo, avec les pierres noires, avait construit une position ambitieuse au centre du goban. Lee Sedol devait trouver un moyen de combattre cette influence sans s’enfermer dans des échanges qui renforceraient encore son adversaire.
Au soixante-dix-huitième coup, il joua une pierre blanche dont la portée ne fut pas immédiatement reconnue par tous les observateurs. Ce coup, devenu célèbre sous le nom de « coup divin » dans de nombreux commentaires, introduisait des possibilités tactiques particulièrement difficiles à traiter.
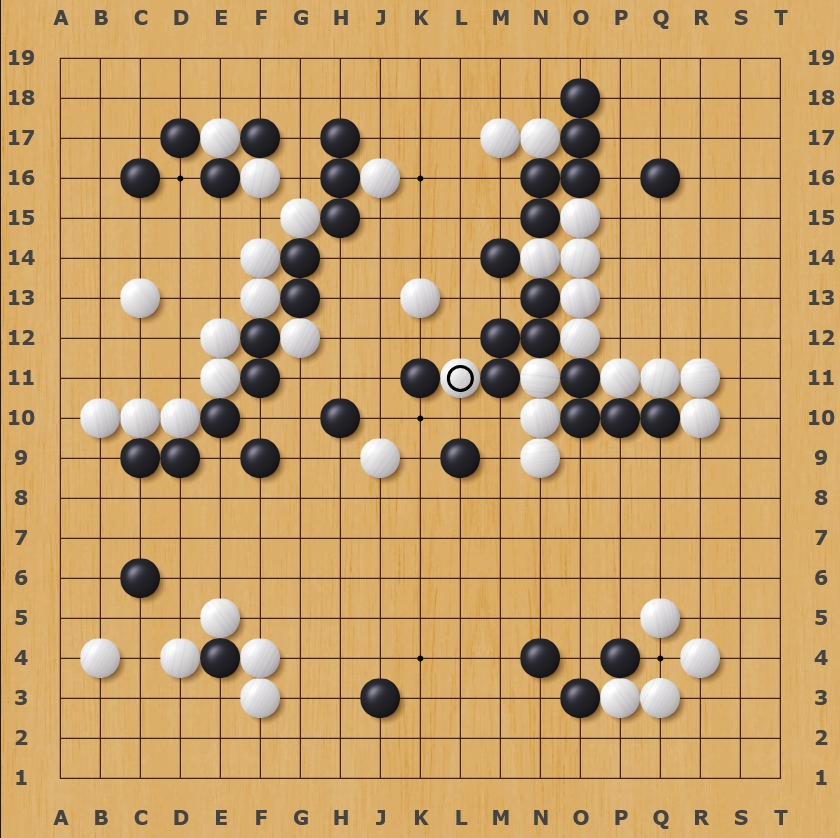
L’équipe de DeepMind indiqua ensuite que son programme avait attribué une probabilité extrêmement faible à ce choix. AlphaGo fut confronté à une continuation qu’il avait manifestement mal anticipée et commença à jouer plusieurs coups défavorables.
Lee Sedol sut exploiter cette situation et remporta la partie après l’abandon d’AlphaGo.
Cette victoire ne remettait pas en cause la supériorité démontrée par le programme dans l’ensemble de la rencontre. Elle montrait cependant qu’AlphaGo n’était pas infaillible et, surtout, que l’inventivité humaine pouvait encore découvrir des ressources que la machine avait insuffisamment évaluées.
Il serait d’ailleurs réducteur de voir dans cette quatrième partie une revanche de l’homme sur la machine. Son intérêt est plus riche : les deux adversaires ont révélé, à quelques jours d’intervalle, des possibilités qui ont obligé les observateurs à regarder le goban autrement.
La deuxième partie AlphaGo-Lee Sedol
Comment AlphaGo avait-il appris à jouer ?
Pour comprendre ce qui s’est passé en 2016, il faut abandonner une idée assez répandue : AlphaGo ne disposait pas simplement d’une immense bibliothèque de parties professionnelles dans laquelle il recherchait la position la plus ressemblante.
Le programme utilisait des réseaux neuronaux capables d’examiner une position et d’estimer quels coups méritaient d’être explorés. D’autres mécanismes contribuaient à évaluer les chances de victoire. Ces estimations étaient associées à une recherche arborescente permettant d’étudier différentes continuations sans devoir examiner toutes les possibilités.
L’apprentissage reposait initialement sur des parties jouées par de forts joueurs humains. Mais AlphaGo avait également progressé en jouant contre lui-même, au cours d’un entraînement destiné à renforcer sa capacité à choisir les coups conduisant à la victoire.
Il ne faut pas imaginer que le programme raisonnait comme un professeur de Go capable de justifier chaque pierre en français ou en japonais. Il apprenait à reconnaître des régularités et à évaluer des positions à partir de calculs et d’entraînements successifs, selon un fonctionnement très différent de l’enseignement humain traditionnel.
Cette différence explique une part de l’étonnement provoqué par ses coups. Un professionnel s’appuie sur une histoire du jeu, sur des modèles qu’il a étudiés, sur ses expériences et sur les explications de ses maîtres. AlphaGo utilisait d’autres méthodes pour parvenir à ses décisions et pouvait donc privilégier des continuations que cette formation humaine rendait moins spontanées.
La recherche se poursuivit après Séoul. En 2017, DeepMind présenta AlphaGo Zero, une nouvelle version capable d’apprendre à partir des seules règles du jeu et de parties disputées contre elle-même, sans commencer par l’étude d’une base de parties humaines. Cette distinction est importante : le programme qui affronta Lee Sedol en 2016 et AlphaGo Zero ne possédaient pas exactement les mêmes méthodes d’entraînement.
La progression fut suffisamment spectaculaire pour montrer que les connaissances stratégiques accumulées par les joueurs humains n’épuisaient pas les possibilités d’exploration du Go.
De nouvelles ouvertures et des joseki à réexaminer
L’une des conséquences les plus visibles de l’arrivée des intelligences artificielles concerne les ouvertures.
Les professionnels connaissaient évidemment depuis longtemps la diversité des points d’occupation des coins, les invasions au 3-3, les approches, les extensions et les différentes manières de construire de l’influence. AlphaGo n’a inventé ni ces coups ni les principes auxquels ils répondent. Il a cependant conduit les joueurs à reconsidérer certaines préférences, en donnant davantage de crédit à des continuations autrefois jugées secondaires ou prématurées.
L’invasion relativement précoce du point 3-3 sous une pierre placée au hoshi est devenue l’un des exemples les plus connus de cette évolution. Elle existait bien avant les programmes modernes, mais les analyses de l’IA ont contribué à modifier la manière dont les joueurs professionnels évaluent le compromis entre la prise immédiate du coin et l’influence laissée à l’adversaire.
D’autres variantes de joseki ont connu des transformations comparables. Certains échanges considérés comme naturels ont été abandonnés ou retardés, tandis que des coups auparavant peu employés ont trouvé une nouvelle place dans la pratique professionnelle.
Il serait pourtant dangereux d’en déduire que l’IA a remplacé les anciens joseki par une liste de séquences définitivement correctes. Un joseki demeure une manière de parvenir à un résultat localement équilibré, dont l’intérêt dépend de la position générale. Les évaluations numériques peuvent enrichir sa compréhension, mais elles ne dispensent pas d’examiner les pierres qui se trouvent ailleurs sur le goban.
Pour un amateur, cette évolution comporte donc une leçon qui dépasse largement l’étude des ouvertures : les séquences ne doivent pas être mémorisées comme des formules indépendantes de leur contexte. Mieux vaut comprendre ce que chaque joueur obtient, quels groupes sont renforcés et quelles possibilités restent disponibles.
L’intelligence artificielle devient un partenaire d’étude
Après la victoire contre Lee Sedol, AlphaGo poursuivit sa progression. En mai 2017, il affronta le champion chinois Ke Jie lors du Future of Go Summit organisé à Wuzhen et remporta les trois parties. DeepMind annonça ensuite que le programme ne participerait plus à de nouvelles confrontations compétitives de ce type.
Son influence sur le jeu ne s’arrêta évidemment pas là.
Les recherches menées autour d’AlphaGo ont inspiré d’autres projets, dont certains ont été développés de manière ouverte. Leela Zero, puis KataGo, ont notamment contribué à rendre accessibles des moteurs de Go d’une force exceptionnelle. Ces outils ont progressivement trouvé leur place dans des logiciels d’étude, des interfaces de révision de parties et des services en ligne.
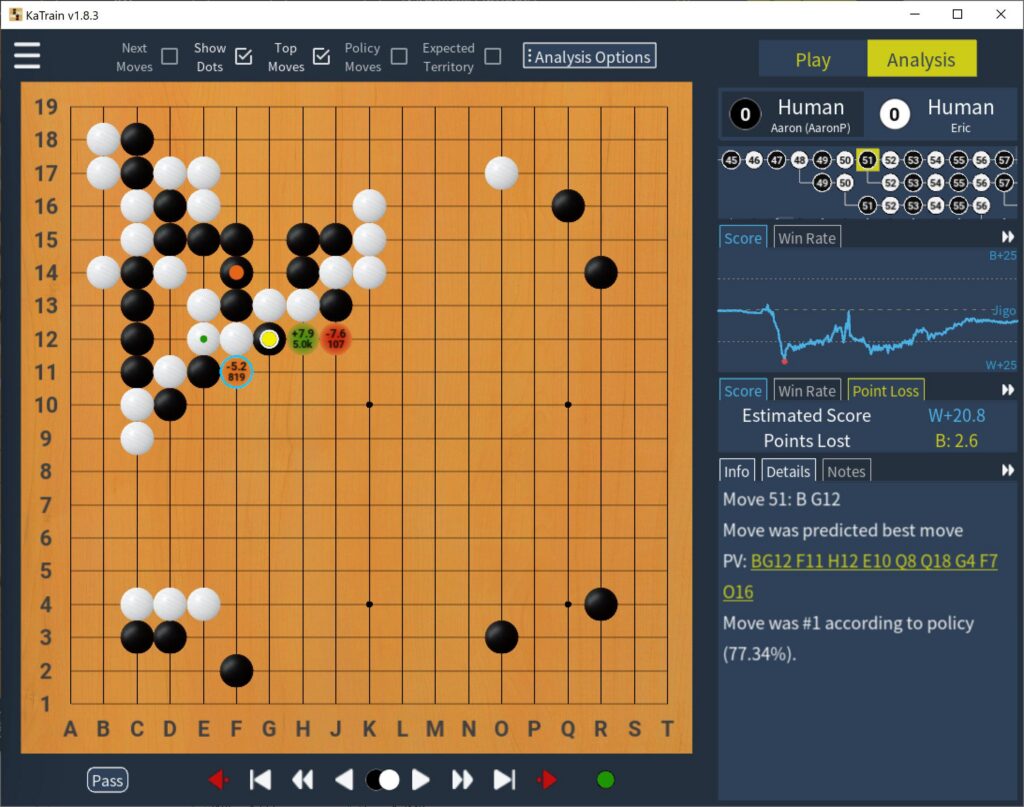
Pour un amateur, l’évolution est considérable. Il est désormais possible de charger le relevé d’une partie, d’examiner plusieurs continuations, de consulter une estimation des chances de victoire ou de voir comment le territoire potentiel pourrait évoluer.
KataGo apporte notamment des estimations du score et de la propriété probable des intersections, particulièrement utiles pour examiner des parties amateurs. Une variation de probabilité de victoire, prise isolément, peut en effet être trompeuse lorsqu’un joueur possède déjà un avantage important : un coup médiocre ne suffit pas toujours à faire basculer la partie, même s’il abandonne inutilement plusieurs points.
Ces fonctionnalités facilitent l’identification de certains moments critiques. Elles peuvent aussi aider à découvrir des possibilités tactiques ou stratégiques auxquelles on n’aurait pas pensé.
Mais l’accès à ces analyses ne garantit pas leur compréhension.
Lorsqu’un moteur indique qu’un coup a fait perdre plusieurs points, il signale un résultat de son évaluation. Il ne sait pas nécessairement expliquer sous une forme pédagogique pourquoi le coup était difficile à jouer, quelle erreur de raisonnement a conduit à le choisir ou quel principe devrait être travaillé pour éviter de reproduire la même faute.
C’est précisément dans cet espace que l’enseignement humain, les livres et l’analyse personnelle conservent toute leur importance.
L’IA fait-elle réellement progresser les joueurs ?
Les effets de l’intelligence artificielle sur la pratique professionnelle ont fait l’objet de recherches qui permettent aujourd’hui d’aller au-delà des impressions.
Une étude publiée en 2023 dans les Proceedings of the National Academy of Sciences, à partir de l’analyse historique de parties professionnelles, a mis en évidence une amélioration des décisions humaines après l’arrivée des programmes surhumains. Les auteurs ont également observé une augmentation de la nouveauté de certains choix, suggérant que l’IA pouvait encourager les joueurs à explorer des continuations jusque-là négligées.
Une autre étude, publiée en 2025 dans PNAS Nexus, apporte un éclairage complémentaire. En examinant près de 70 000 parties professionnelles jouées entre 2003 et 2021, elle montre que l’adoption de nouvelles connaissances issues des programmes d’IA s’est accompagnée d’une concentration accrue de certains schémas d’ouverture. Les joueurs ont découvert de nouvelles possibilités, mais ont aussi eu tendance à privilégier plus fréquemment un nombre relativement limité de continuations.
Ces deux observations ne se contredisent pas nécessairement. L’arrivée d’un outil capable de proposer des idées nouvelles peut d’abord élargir les perspectives, puis conduire les joueurs à adopter collectivement les variantes qu’ils jugent les plus efficaces. Le progrès de la qualité moyenne des décisions n’implique pas que les styles individuels deviennent automatiquement plus variés.
Pour l’amateur, le risque est différent mais tout aussi réel. À force d’examiner chaque partie à travers les recommandations d’un moteur, on peut finir par chercher systématiquement le coup préféré de l’IA, sans comprendre les raisons de ce choix et sans tenir compte de son propre niveau.
Un programme extrêmement fort peut recommander une continuation parfaitement justifiée, mais dont la réussite dépend d’une lecture tactique que le joueur ne maîtrise pas encore. Une solution théoriquement supérieure ne devient pas nécessairement la plus instructive pour celui qui cherche à progresser.
La bonne utilisation de l’IA consiste peut-être à lui demander moins souvent quel coup aurait dû être joué, et davantage à examiner les raisons pour lesquelles notre décision a posé problème. Il est utile de revenir d’abord sur la position sans assistance, de chercher ses propres variantes, puis de comparer cette réflexion aux indications du moteur.
On apprend alors à se servir de la machine comme d’un instrument de vérification et de découverte, plutôt que comme d’une autorité qu’il suffirait d’imiter.
Dix ans après, un jeu toujours humain
Les conséquences d’AlphaGo dépassent largement la défaite d’un champion. Les professionnels ont modifié certaines habitudes, les amateurs peuvent étudier avec des outils exceptionnellement puissants et des questions que l’on croyait parfois réglées ont été rouvertes. L’intelligence artificielle a montré que le Go conservait des ressources insoupçonnées, malgré des siècles de pratique et d’enseignement.
On pourrait en conclure que la machine a définitivement pris la place des maîtres. Ce serait confondre deux activités différentes : trouver des coups très forts et transmettre une compréhension du jeu.
Une analyse informatique peut révéler une continuation meilleure que celle que l’on envisageait. Elle ne remplace pas pour autant l’effort nécessaire pour comprendre la position, développer sa lecture ou reconnaître les erreurs qui reviennent régulièrement dans ses parties. Elle ne remplace pas non plus le plaisir de jouer contre une autre personne, d’échanger après la rencontre et de découvrir peu à peu une manière personnelle d’aborder le goban.
C’est peut-être là que réside le paradoxe le plus intéressant de cette révolution. En devenant beaucoup plus fortes que les meilleurs joueurs humains, les intelligences artificielles n’ont pas épuisé le mystère du Go. Elles ont au contraire révélé combien certaines de nos certitudes reposaient sur des habitudes, des traditions ou des interprétations qui méritaient d’être discutées.
Dix ans après Séoul, le goban conserve ses 361 intersections, ses pierres noires et blanches et ses règles toujours aussi sobres. Les instruments qui permettent de l’étudier ont profondément changé. Mais les questions que se pose le joueur en regardant une position restent familières : où jouer, pourquoi choisir ce coup plutôt qu’un autre, et que se passera-t-il si l’adversaire répond autrement ?
L’intelligence artificielle peut désormais nous aider à explorer ces questions avec une profondeur inédite. Encore faut-il continuer à se les poser soi-même.
Pour aller plus loin : les cinq parties historiques
Les cinq parties disputées entre Lee Sedol et AlphaGo, en mars 2016, constituent un témoignage exceptionnel de l’histoire contemporaine du Go. Nous avons présenté deux d’entre elles dans cet article, notamment les célèbres coups 37 d’AlphaGo et 78 de Lee Sedol. Les lecteurs qui souhaitent découvrir l’intégralité de cette rencontre peuvent également télécharger les relevés des trois autres parties et les examiner à leur rythme.
9 mars 2016 — Première partie. Lee Sedol joue Noir et AlphaGo remporte cette première confrontation, annonçant une rencontre bien plus difficile que ne l’avait imaginé le champion coréen. Télécharger le fichier SGF.
12 mars 2016 — Troisième partie. AlphaGo obtient sa troisième victoire consécutive et s’assure définitivement le gain de la rencontre. Télécharger le fichier SGF.
15 mars 2016 — Cinquième partie. Après la victoire de Lee Sedol lors de la quatrième manche, AlphaGo conclut la rencontre par un dernier succès, portant le résultat final à quatre victoires contre une. Télécharger le fichier SGF.
Ces trois relevés sont mis à disposition par la British Go Association, dont le compte rendu permet également de retrouver les commentaires et les résultats des cinq parties.